台本どおりに話せてなくて当たり前。テロップは「実際に喋った内容」から起こす
台本を書いても、いざ撮ると言い回しが変わったり補足を喋ったりして、そのままテロップには使えません。結局は聞き直して「実際に喋った内容」を起こし直すことになる——この地味に重い作業を、タイムスタンプ付きの文字起こしでどう軽くするかを書きます。
台本を書いてから撮る人は多いと思います。私もそうです。話す順番を決めて、言い回しも用意して、これで編集はラクになるはず——と思って撮る。ところが、いざ録画を回すと、台本どおりには喋れないんですよね。
言い回しがその場で変わる。言いよどんで言い直す。話しながら「あ、これ補足しておこう」と、台本にない一言を足す。撮り終えて見返すと、手元の台本と実際に喋った内容は、微妙に、でも確実にズレています。
このズレのせいで、地味だけど毎回きっちり時間を取られる作業が発生します。テロップを、台本のコピペでは作れない、という問題です。
なぜ台本コピペでテロップが作れないのか
頭の中では、こう期待しています。「台本があるんだから、それをそのままテロップに流し込めば字幕は完成でしょう」と。実際、台本どおりにピタッと喋れているなら、それでいい。
でも現実はそうならない。理由は単純で、テロップは”実際に画面で喋っている言葉”と一致していないと気持ち悪いからです。喋りは「えっと、これはですね」なのに、テロップだけ台本の「これは」だと、口の動きと文字がズレて、見ている側は微妙な違和感を覚えます。補足で足した一言にはそもそも台本がないので、テロップが付けられない。逆に、台本にあったけど本番でカットした文は、テロップに残すと嘘になる。
つまり台本は「だいたい合ってるけど、そのままは使えない下書き」でしかない。テロップにするには、実際に喋った内容へ直す必要があります。そして「直す」といっても、部分的な修正では済まなくて、結局こうなります。
結局「聞き直して起こし直す」——これが一番だるい
台本を横目に、動画を再生しながら、実際の発話に合わせてテキストを直していく。これが想像以上に重い作業です。
数字を出すと、私の場合、1分の喋りを起こすのに、十分以上かかることもあります。理由は聞き取りです。一回で全部は拾いきれないので、巻き戻してもう一回聞く。早口になった箇所、言い直した箇所、口ごもった箇所は、二回三回と往復する。1分の動画でこれなので、少し長くなると、文字起こしだけで平気で夕方になります。
しかもこれ、避けて通れないんですよね。テロップを付ける以上、実際に喋った言葉を文字にする工程は必ず要る。台本があってもなくても、ここは発生する。ずっと「これ、なんとかならないのか」と思っていた作業です。
(このあたりの「テロップづくりがそもそも面倒」という話は、前に別の記事で、DogaRunを作るきっかけとして書きました。)
ズレは「素材探し」にも効いてくる
台本と実発話のズレが面倒なのは、テロップだけの話ではありません。
解説系や語り系のショートだと、喋りに合わせてイメージ画像やイメージ映像を差し込むことがあります。このとき素材を探す基準になるのは、台本ではなく「実際に、何秒から何秒までの間、何を喋っているか」です。台本を頼りに素材を探すと、本番で言い回しを変えていたり順番が前後していたりして、微妙に合わない。結局ここでも、実際に喋った内容と、その時間を見ながら探すことになります。
だから「実際に喋った内容を、時間つきで正確に持っておく」ことは、テロップづくりの下ごしらえであると同時に、そのあとの作業全部の土台になります。逆に言うと、ここが雑だと後工程がずっと雑なままです。
直すべきは「台本との照合」ではなく「実発話を起点にすること」
ここまでを整理すると、やるべきことははっきりしています。台本をどう活かすか、で悩むのをやめて、実際に喋った内容そのものを、正確に・時間つきで起点データにする。テロップも、素材合わせも、そこから始める。
問題は、その「実発話を時間つきで起こす」を手作業でやると、さっきの巻き戻し地獄になることです。ここを人力の気合いでやり続けるのは、もう限界がある。必要なのは、聞き直して打ち直す作業を、機械に肩代わりさせて、人は”直すだけ”にすることです。
DogaRun でやっていること
DogaRun は、この「実際に喋った内容を、時間つきで起こす」ところを自動化しています。
動画や音声を入れると、音声認識が中身を文字起こしします。ポイントは、時刻を音声から実測して付けること。「この単語は何秒あたりで喋られたか」を、実際の音に基づいて割り当てます。台本と突き合わせるのではなく、実際に鳴っている音から起こすので、本番で言い回しを変えても、補足を足しても、その”喋ったとおり”がテキストになります。
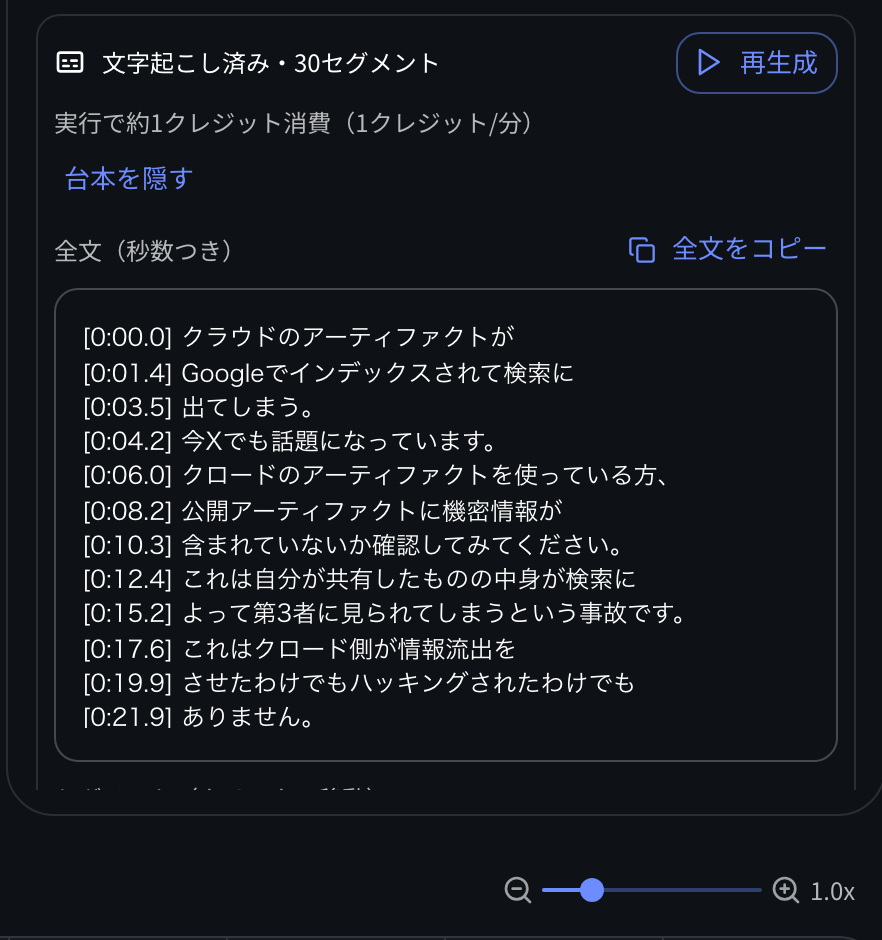 DogaRunで実際に文字起こしした結果の画面。台本ではなく、本番で喋った内容がそのまま秒数つきで並びます。時刻は音声から実測しているので、この下地をそのまま字幕のタイミングに使えます(画面はこの記事の下書きとは別の、筆者の実際のショート動画のものです)。
やることが「ゼロから聞き直して打つ」から「出てきた下地を直す」に変わります。具体的には、
- 聞き直しの往復が減る:全体は自動で起こしてくれるので、巻き戻して何度も聞く作業がまるごと軽くなる。ここが一番効きます。
- 時間が最初から付いている:どの言葉が何秒か、が下地の時点で入っているので、テロップの表示タイミングをゼロから合わせ直す往復が要らない。長い塊は、意味の切れ目で区切って並べ直すだけで整います。
- 実発話が残る:台本ではなく、本番で本当に喋った内容がテキストとして手元に残る。これが素材探しやあとからの見返しの土台になります。
自動の文字起こしは万能ではありません。固有名詞や数字、早口の箇所は外すことがあるので、最後は自分の目で直す前提です。DogaRun がやるのは「直す量を減らす」ことで、最終チェックまで消してくれるわけではありません。それでも、「台本を横目に全部を聞き直して打ち直す」から「出てきた下地を直す」に変わるだけで、この工程の重さはかなり違います。
まとめ
- 台本を書いても、撮るとズレる。言い回しは変わるし、補足も足す。だから台本コピペでテロップは作れない。
- 結局は聞き直して実発話を起こし直すことになり、1分に十分以上かかることもある。避けて通れない工程。
- ズレは素材探しにも波及する。だから「実際に喋った内容を、時間つきで正確に起点にする」のが本筋。
- 手作業の聞き直しは機械に任せ、人は下地を直すだけにする。DogaRun はそこを自動化していますが、最終チェックは自分の目で。
台本は、あくまで撮るためのもの。テロップは、実際に喋った内容から起こす。この切り分けができると、文字起こしまわりの作業はだいぶ見通しがよくなります。