文字起こしはなぜ面倒で時間がかかるのか——1分の動画に10分以上溶ける正体
手作業の文字起こしは、動画の尺の何倍も時間がかかります。1分の喋りに10分以上かかることも珍しくない。その正体は「聞き取れずに巻き戻す」こと。なぜそんなに溶けるのかを分解し、全部を手で起こすのをやめて下地を直すだけにする、という抜け道を書きます。
「たった1分の動画なのに、なんでこんなに時間がかかるんだ」。文字起こしをやると、これを痛感します。
大げさではなく、1分の喋りを起こすのに10分以上かかることもある。10分の動画なら、それだけで午前中が消えます。撮影より、カット編集より、この地味な作業に一番うんざりする——なぜそんなに溶けるのか、分解してみます。
時間が溶ける正体は「巻き戻し」
再生時間が1分なら、聞きながら打っても1分ちょっとで終わりそうな気がします。でも実際はそうならない。理由は単純で、一度では聞き取りきれないからです。
- 早口になった箇所は、一回で拾えない。
- 言い直したところ、口ごもったところは、どっちが本番かを聞き分けるためにもう一回。
- 固有名詞や数字は、聞き間違えると意味が壊れるので、慎重に確認する。
そのたびに巻き戻して、二回三回と同じ数秒を聞く。たとえば固有名詞がひとつ出てくるだけでも、一度で確信が持てなければ前後ごと聞き直します。1文のなかにそういう引っかかりが2つ3つあれば、その1文だけで再生の何倍も時間を使っている。この「巻き戻して聞き直す」の積み重ねが、尺の何倍もの時間の正体です。再生1分ぶんを、実際には三分も四分も聞いていることになる。
「速く打つ」「倍速で聞く」では、あまり削れない
まずやりがちなのが、タイピングを速くする、再生を1.5倍や2倍にする、といった対処です。ショートカットや文字起こし用のフットペダルを導入して、操作の手数を詰める人もいます。でも、ここは時間が溶ける本丸ではありません。
ボトルネックは打鍵の速さではなく、聞き取りのほうにあるからです。倍速にすると早口の箇所や語尾はますます拾えず、結局そこだけ等速に戻して聞き直す。再生を速めたぶん、巻き戻しの回数が増えて相殺されます。操作をいくら詰めても、「もう一回聞かないと分からない」という一手が残る限り、尺の何倍もかかる構造は変わりません。
だから、速く打つ・速く聞くを鍛えるより、「聞き直す往復そのもの」を無くすほうに手を打つのが筋がいい。ここがこの記事の結論です。
さらに、タイムスタンプを手で合わせると倍かかる
テロップにするなら、テキストを起こすだけでは終わりません。「この文は何秒から何秒まで表示するか」という時間も要ります。
これを手で合わせるのは、文字起こしとはまた別の往復です。1文ごとに頭出しして、喋り始めの秒を確認し、喋り終わりで切る。少しズレるだけで字幕が声より先に出たり、消え残ったりして気持ち悪いので、コンマ数秒の単位で微調整することになります。
文字を起こす手間と、時間を合わせる手間。この2つが重なって、1分の動画が10分以上に膨らみます。
「全部を手で起こす」のは、そもそも無理筋
大事なのは、これは気合いや慣れで解決する話ではない、ということです。多少は速くなっても、「巻き戻して聞き直す」という作業の性質上、尺の何倍かかる構造は変わりません。
だから発想を変えます。全部を自分の耳と手でやるのをやめて、機械に下地を作らせて、人は直すだけにする。
抜け道は「下地を作って、直す」
具体的には、こういう分担にします。まず、全体の文字起こしと時間つけは音声認識にまかせる。ここで「巻き戻して聞き直す」往復がまるごと消えます。
この「音声認識にまかせる」部分は、Google Cloud の Speech-to-Text(STT)のような音声認識APIを使うと、単語ごとに実測の時刻つきで文字起こしを取れます。音そのものから測った時刻なので、字幕のタイミングの土台にそのまま使える。実際にどんなコードでその下地を作るのかは、別の記事でサンプル付きで書きました。
人が直すのは3つだけ
下地ができたら、人がやるのは全体を読み返すことではありません。機械が外しやすく、かつ間違うと痛いところ——この3つに絞って直します。
- 固有名詞(チャンネル名・商品名など):前後の文脈から補正されにくく、外すと一番目立つ。たとえば自分のチャンネル名が毎回微妙に違う表記になる、といったことが起きるので、ここは一括で直しておく。
- 数字・日付・金額:「1300円」が「1500円」になるような聞き間違いは、そのまま誤情報になります。喋りで数字が出るタイプの動画なら、その箇所だけは音を確認する。
- 区切り:1枚に詰まりすぎた字幕を、意味の切れ目で分ける。読みやすさに直結するので、長い1文は句点や助詞のところで割る。
逆に、語尾の細かい揺れや「えー」「あのー」は、ショートの字幕なら神経質にならなくていい部分です。直すところを絞れば、確認は流し読みで済みます。
「ゼロから起こす」と「出てきた下地を直す」は、同じ作業に見えて重さが全然違います。前者は尺の何倍もかかり、後者は固有名詞・数字・区切りを見て直すだけ。同じ「文字起こし」でも、向き合う作業がまるで変わります。
DogaRun でやっていること
DogaRun は、この「下地を作る」ところを担います。動画や音声を入れると、音声認識が全体を文字起こしし、時刻を音声から実測して付けます。人がやるのは、出てきたテキストを直すことと、区切りを整えることだけ。巻き戻して聞き直す往復と、秒を手で合わせる往復が要らなくなります。
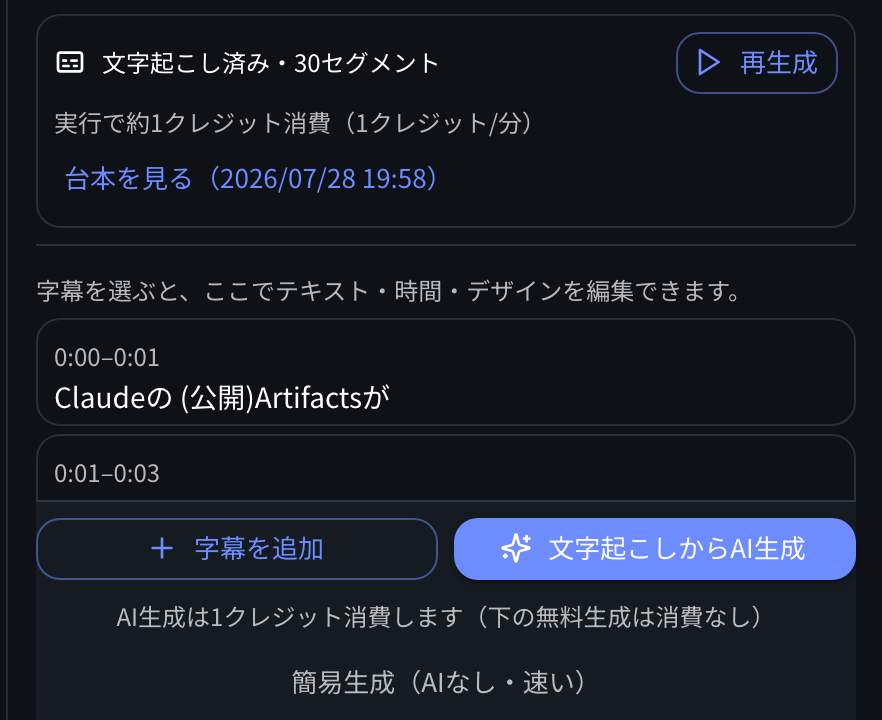 DogaRunで文字起こしした直後の画面。全体が自動で起こされて「済み」になっています。人はここから直すだけ。巻き戻して聞き直す往復がまるごと要らなくなります。
自動の文字起こしも万能ではありません。特に固有名詞や数字は外すことがあるので、最後は自分の目で直す前提です。それでも、時間が溶ける原因だった「巻き戻し」がなくなるぶん、人が向き合うのは”直す”作業だけになります。
まとめ
手作業の文字起こしが尺の何倍もかかるのは、「一度で聞き取れず巻き戻す」からで、これは気合いでは変わらない構造の問題です。だから、全体は自動で起こして、人は固有名詞・数字・区切りの3つだけを直す——ここに作業を絞るのが、溶けていた時間を取り戻す一番の近道です。