文字起こしは、字幕のためだけじゃない。動画制作の「起点データ」だと考える
文字起こしを「字幕を作るためのもの」と思っていると、その価値を半分も使えていません。撮影で台本からズレた"実際に喋った内容"を、秒(タイムスタンプ)つきで正確に持つ。それはテロップだけでなく、素材探し・尺合わせ・見返し・使い回しまで、動画制作の全部の起点になります。DogaRunを作るに至った考え方を書きます。
動画を作る人にとって、文字起こしは「面倒だけど、字幕を作るために仕方なくやる作業」だと思われがちです。テロップを作り終えたら、その文字起こしはもう用済み。そういう扱いになっている人が多い。
自分もずっとそう思っていました。でも、何本も作るうちに考えが変わりました。いま思っているのはこうです。文字起こしは、字幕を作るためのものじゃない。動画制作の「起点データ」だ。 撮影で台本からズレた”実際に喋った内容”を、秒(タイムスタンプ)つきで正確に持っておく。それがあると、テロップだけでなく、その先の作業がまとめて軽くなる。この記事は、その考え方の話です。
撮影後は、台本をそのまま起点にできない
「台本があるんだから、それを使えばいいのでは?」と思うかもしれません。台本は企画や撮影の起点にはなります。でも、編集の工程では話が別です。
いざ撮影すると台本からズレます。言い回しは変わるし、その場で補足も足す。だから編集の工程では、台本は「だいたい合ってるけど、そのままは使えない下書き」でしかない。編集の起点にできるのは、台本ではなく、本番で実際に喋った内容のほうです。
そして、その「実際に喋った内容」を手作業で起こすと、1分の動画に十分以上かかる。聞き取れずに巻き戻す往復で、尺の何倍もの時間が溶ける。だからこそ、ここは自動で下地を作って、人は直すだけにしたい。起点データは、なるべく手間をかけずに正確に用意したいわけです。
「時刻がついている」ことが効いてくる
起点データのもう一つの条件が、秒(タイムスタンプ)がついていることです。これはテロップの表示タイミングに使うから、というだけではありません。時刻がつくと、テロップ以外の作業にも効いてきます。
たとえば素材探し。解説系のショートでイメージ画像を差し込むとき、「何秒から何秒で何を喋っているか」がわかっていると、どこに何を当てるかの判断が一気に速くなります。
具体的にはこういうことです。60秒の解説動画が、こう起こされていたとします。
0:12–0:18 生成AIは検索エンジンとは違います
0:18–0:27 大量のデータから、次の言葉を予測しています
これがあれば、「0:12 から検索画面のカット、0:18 から”予測”をイメージした素材に切り替え」という編集の判断が、動画を再生し直さなくてもテキストの上だけでできます。時刻つきの文字起こしは、いわば編集指示書になるわけです。
DogaRun では、この時刻を音声そのものから実測して付けています。テロップのタイミングも素材合わせも、この時刻を土台にするので、起点の時刻が正確であることは外せません。
テロップの「先」に効く
起点データという言い方をするのは、テロップを作った後にも効くからです。正確に喋った内容が時刻つきで残っていれば、それは字幕を作って終わりにせず、捨てずに使い回せる資産になります。
ここで効くのが、動画そのものは検索できないが、文字になっていれば検索できるという違いです。動画は再生して中身を確認するしかありませんが、喋った内容がテキストになっていれば、目的の話をキーワードで一発で引ける。たとえばシリーズものを続けていて「この話、前にもしたっけ?」となったとき、過去回のテキストを検索すれば「どの動画で何を言ったか」がすぐわかる。動画を頭から見返して探すより、ずっと速い。喋った内容を出発点に、概要欄・SNS・記事など別の形へ作り替えるときの土台にもなります。
一つの正確な文字起こしが、この全部の入り口になる。だから「起点データ」と呼んでいます。
なぜ、これを作ることにしたか
自分がこの考えにたどり着いたのは、頭で考えたからではなく、単純に自分が困っていたからです。発信をするようになって、テロップの重要さと面倒さに気づいた。とくに、台本どおりに話せないから毎回聞き直して起こし直す、あの作業が本当に嫌だった。
そのときに思ったのが、「テロップのためだけに我慢してこれをやるのは、割に合わない。でも、正確に時刻つきで起こせるなら、テロップ以外にも使えるはずだ」ということでした。だったら、その起点データを作るところを楽にすればいい。そう考えて、音声認識で文字起こしとタイムスタンプを自動で作る仕組みを個人で組んだのが、DogaRun の始まりです。
DogaRun でやっていること
DogaRun は、この「起点データ」を作るところを担います。動画や音声ファイルを入れて待つと、実際に喋った内容が、音声から実測した秒つきの全文になって出てきます。台本と突き合わせるのではなく、本番で喋ったとおりのテキストが時刻つきで手元に並ぶ状態です。この一度の文字起こしが、その先の複数の作業の入口を同時に開けます。
 一度の文字起こし(=起点データ)から、制作の各工程が枝分かれする。
出てきた秒つき全文は、「全文をコピー」でまるごと持ち出して、手元に残す資産にもできます。
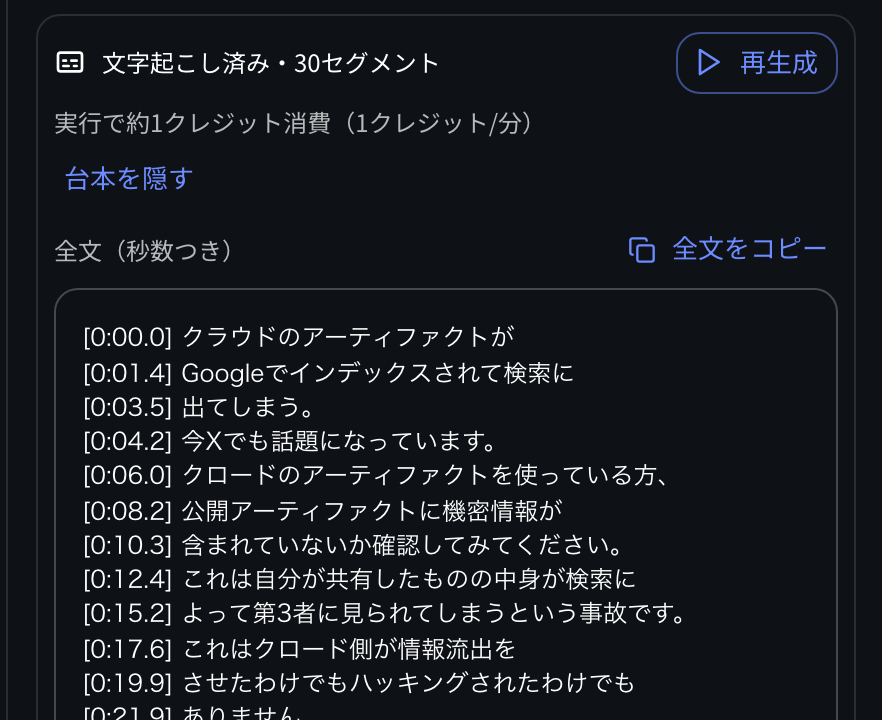 秒つきの全文はワンボタンでまるごとコピーできる。字幕にするだけでなく、見返し・使い回しのためのテキスト資産として、そのまま持ち出せます。
もちろん、自動の文字起こしは万能ではありません。固有名詞や数字は外すことがあるので、最後は人が直す前提です。また、文字起こしから自動で記事化する・他チャネル用に作り替える、といった展開の自動化は、いまの機能にはありません(今後やっていきたい領域です)。ツールがやるのは「正確な起点データを、手間をかけずに用意する」ところまで。そこから先、どう使うかは作り手次第です。
まとめ
- 文字起こしを「字幕のためのもの」と思うと、価値を半分しか使えない。
- 制作の起点にできるのは台本ではなく「実際に喋った内容」。しかも秒つきで正確に。
- それがあると、テロップ・素材探し・尺合わせ・見返し・使い回しまで、まとめて軽くなる。
- だから文字起こしは、字幕の下地ではなく「起点データ」だと考える。
一本の正確な文字起こしを起点に、テロップも素材合わせも見返しも枝分かれさせる。この順番にすると、動画1本ごとにゼロからやり直している感覚がなくなります。
DogaRun でやりたいのは、文字起こしを楽にすることだけではありません。動画制作のいちばん最初に、“使えるデータ”を置くこと。そこから先の制作が、ぜんぶそのデータの上で回りはじめる——そういう作り方にしたいと思っています。